¶ ローカルLLM
¶ このページで分かること
- ローカルLLMを動かす全体構成(推論エンジン+Web UI+検索)の組み合わせ
- LM Studio(Windows)/SearXNG/Open WebUI の役割とつなぎ方
- モデルを選ぶときのVRAM・量子化・モデルサイズの目安
- 実際に組むときの子ページ(Ubuntuでの構築手順)
¶ 選び方(VRAM・量子化・モデルサイズ)
ローカルLLMは、GPUのVRAM(ビデオメモリ)とメモリ容量で「動かせるモデル」が決まる。まずここを押さえると、無駄なダウンロードを減らせる。
| VRAM | 動かせるモデルの目安 | 量子化 | 向く用途 |
|---|---|---|---|
| 8GB | 7〜8Bクラス | Q4_K_M | 要約・チャット・軽いコーディング |
| 12GB | 13Bクラス | Q4_K_M | 長文要約・翻訳 |
| 24GB | 30Bクラス | Q4_K_M | コーディング補助・エージェント |
| 48GB以上 | 70Bクラス | Q4_K_M | 高精度が必要な用途 |
- 量子化は Q4_K_M が扱いやすい。Q8やFP16は品質が上がるが、VRAMを2〜4倍食う。
- 「B(パラメータ数)」が大きいほど賢い傾向だが、速度はVRAMの帯域とCPUの性能に左右される。
- VRAMに収まらないときは一部のレイヤだけCPUへ回す(GPUオフロード)。ただし速度は大きく落ちる。
- 日本語性能はモデルごとの差が大きい。日本語調整済みモデルやQwen系は日本語が得意な傾向がある。
- 重み(GGUFなど)は数GB〜数十GBになる。ストレージの空きも先に確認しておく。
¶ この節の子ページ
- ローカルLLM環境/ubuntu — Ubuntu 24.04で構築する手順(CUDA、Python、必要パッケージ)
- AI・LLM(親ページ) — この節の案内と読む順序
- spotpear_ball — ESP32-S3搭載の小型AIデバイス
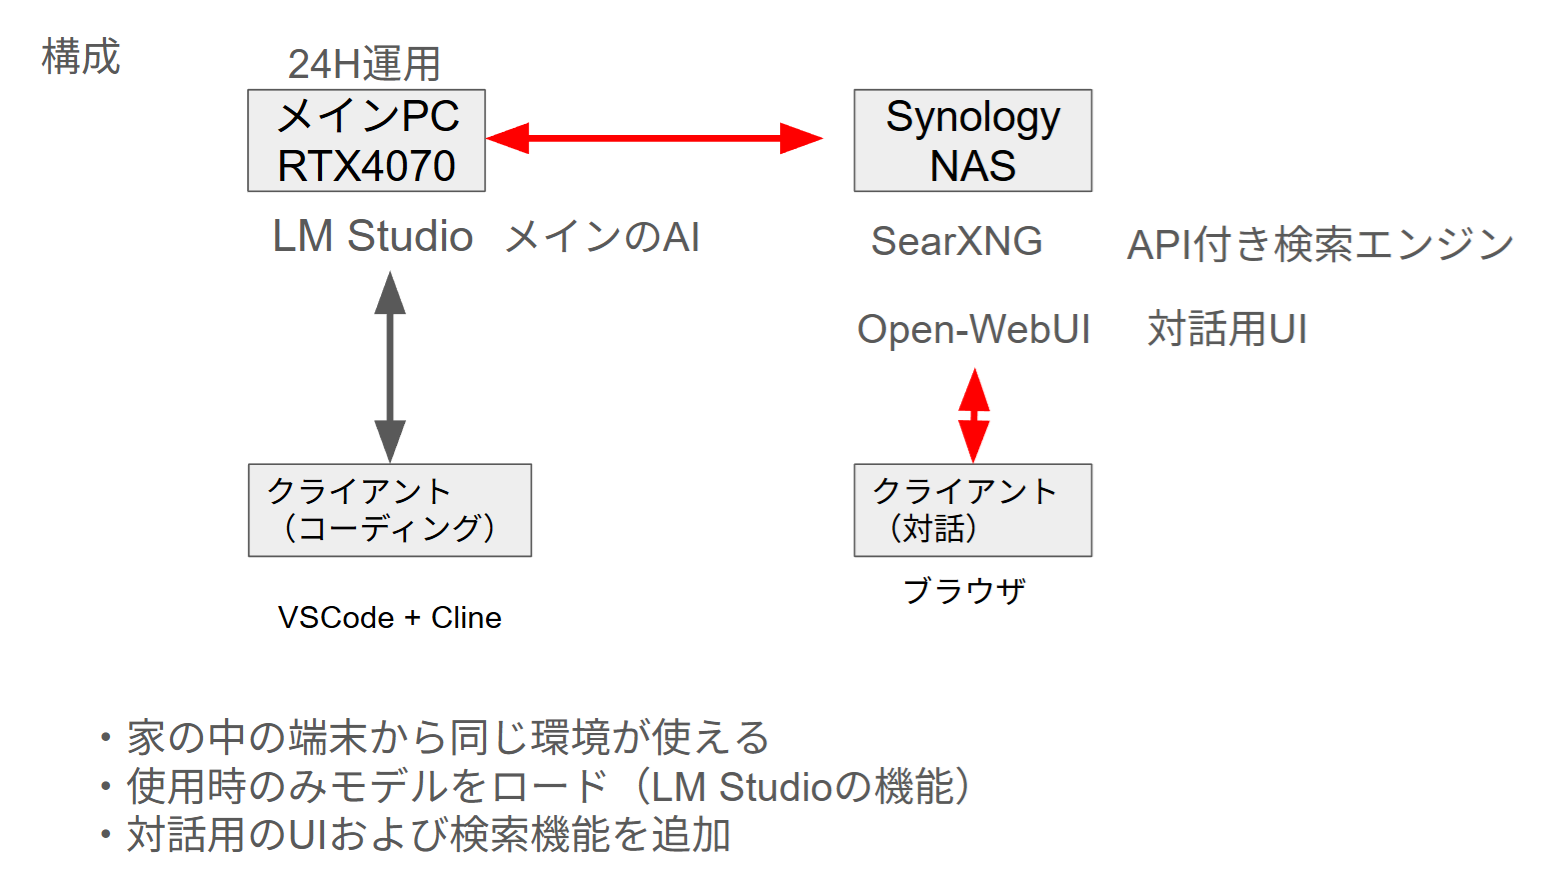
¶ 構成
¶ 設定
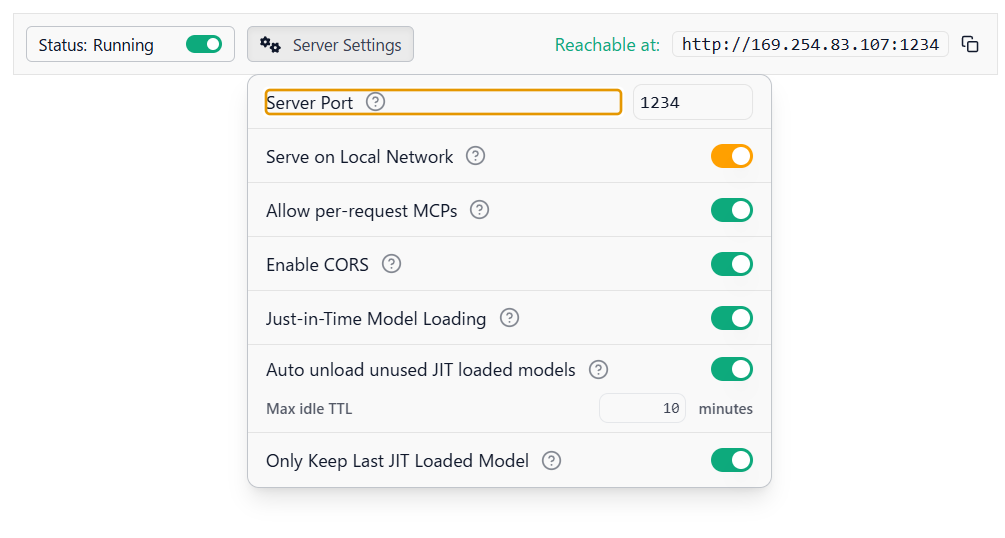
LM Studio(Windows)
https://lmstudio.ai/
SearXNG
https://docs.searxng.org/admin/installation-docker.html
jsonでやり取りできるように
search:
  # remove format to deny access, use lower case.
  # formats: [html, csv, json, rss]
  formats:
    - html
    - json
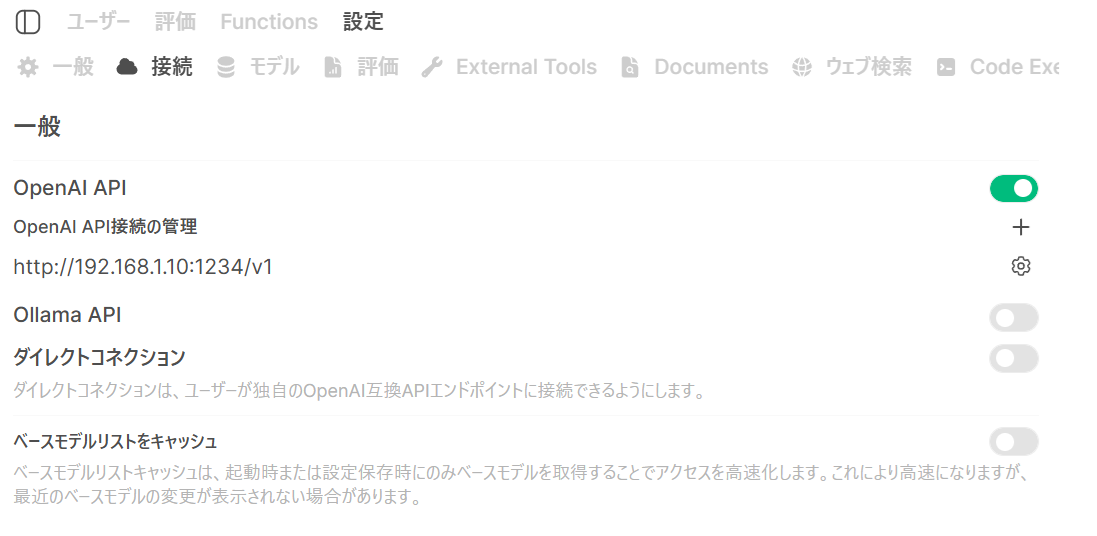
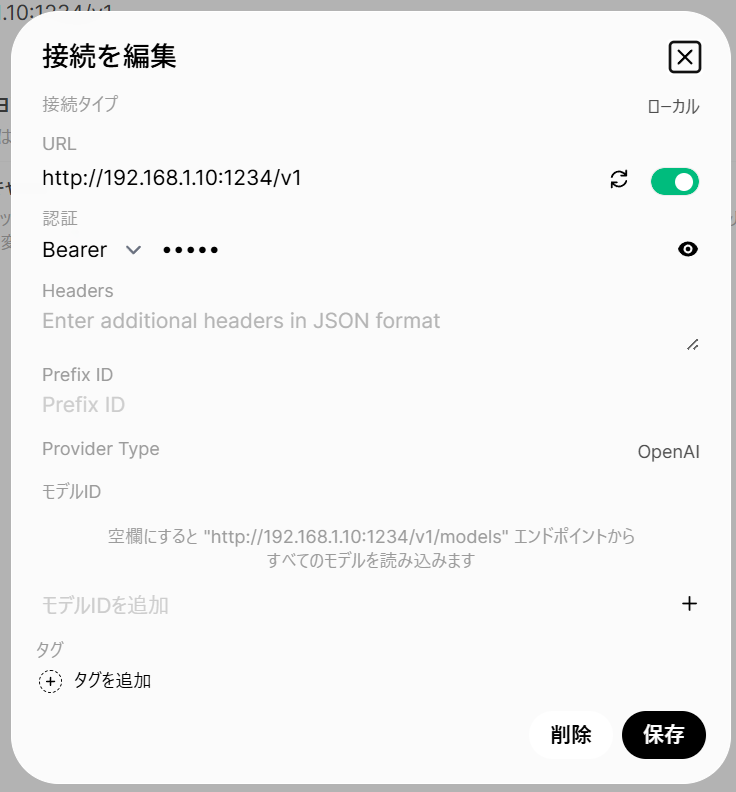
Open-webui
https://github.com/open-webui/open-webui
管理者パネル→設定→接続
¶ よくある質問
Q. GPUが無くてもローカルLLMは動く?
A. 動くが遅い。CPUだけなら7〜8BクラスのQ4量子化で毎秒数トークン程度が現実的なラインだ。メモリはモデルサイズ+α(16GB以上推奨)を確保しておく。
Q. LM StudioとOllamaはどちらを使えばいい?
A. 手軽さ重視ならOllama(CLI中心)、GUIでモデルを選びたいならLM Studio。どちらもOpenAI互換のAPIを出せるので、Open WebUIからは同じように接続できる。
Q. SearXNGをわざわざ立てる理由は?
A. LLMにWeb検索を渡す(検索結果をプロンプトに混ぜる)ためだ。SearXNGなら自前で検索APIを立てられる。設定で formats に json を足さないと、Open WebUIから検索が使えない点に注意する。
Q. モデルはどこから入手する?
A. Hugging Faceが標準の配布元だ。LM Studioなど一部のツールは、ツール内から直接検索・ダウンロードできる。
¶ 参考URL
🤖 このページにはAIエージェント(ノア)による編集・加筆が含まれます。内容の正確性は保証できないため、重要な判断は一次情報でご確認ください。